

Wat als je het beste van twee werelden kunt combineren: krachtige datatransformatie met Talend Cloud en intuïtieve datavisualisatie met Qlik? In deze blog laat Stas van den Braber, Business Intelligence Consultant en Qlik specialist bij Victa, zien hoe je deze tools slim samen inzet voor een efficiënte en schaalbare data-oplossing.
Scroll
![]()
Qlik Talend Cloud: zo verbind je data-integratie met datavisualisatie
Een praktische introductie

Grote voordelen van Qlik Talend Cloud
Qlik Talend Cloud (QTC) is het resultaat van de krachtige combinatie tussen Qlik, bekend van datavisualisatie en analytics, en Talend, specialist in data integratie, kwaliteit en beheer. QTC levert betrouwbare data met behulp van geautomatiseerde pipelines, intelligente transformaties and betrouwbare datakwaliteit.
Volledig geautomatiseerde change data capture (CDC)
QTC levert real-time data uit verschillende bronsystemen aan je gegevensplatform via volledig geautomatiseerde CDC. Je data is altijd up-to-date zonder dat de prestaties van het bronsysteem hieronder lijden. Het proces is volledig no-code, dus je hebt geen enkele regel code nodig om dit te realiseren.
Automatisering van je datawarehouse, data lake of data lakehouse
Met QTC automatiseer je de volledige data pipeline. De handmatige codering en complexiteit van traditionele ETL-processen vervallen, waardoor je sneller, efficiënter en met minder risico werkt.
Betrouwbare data in je organisatie
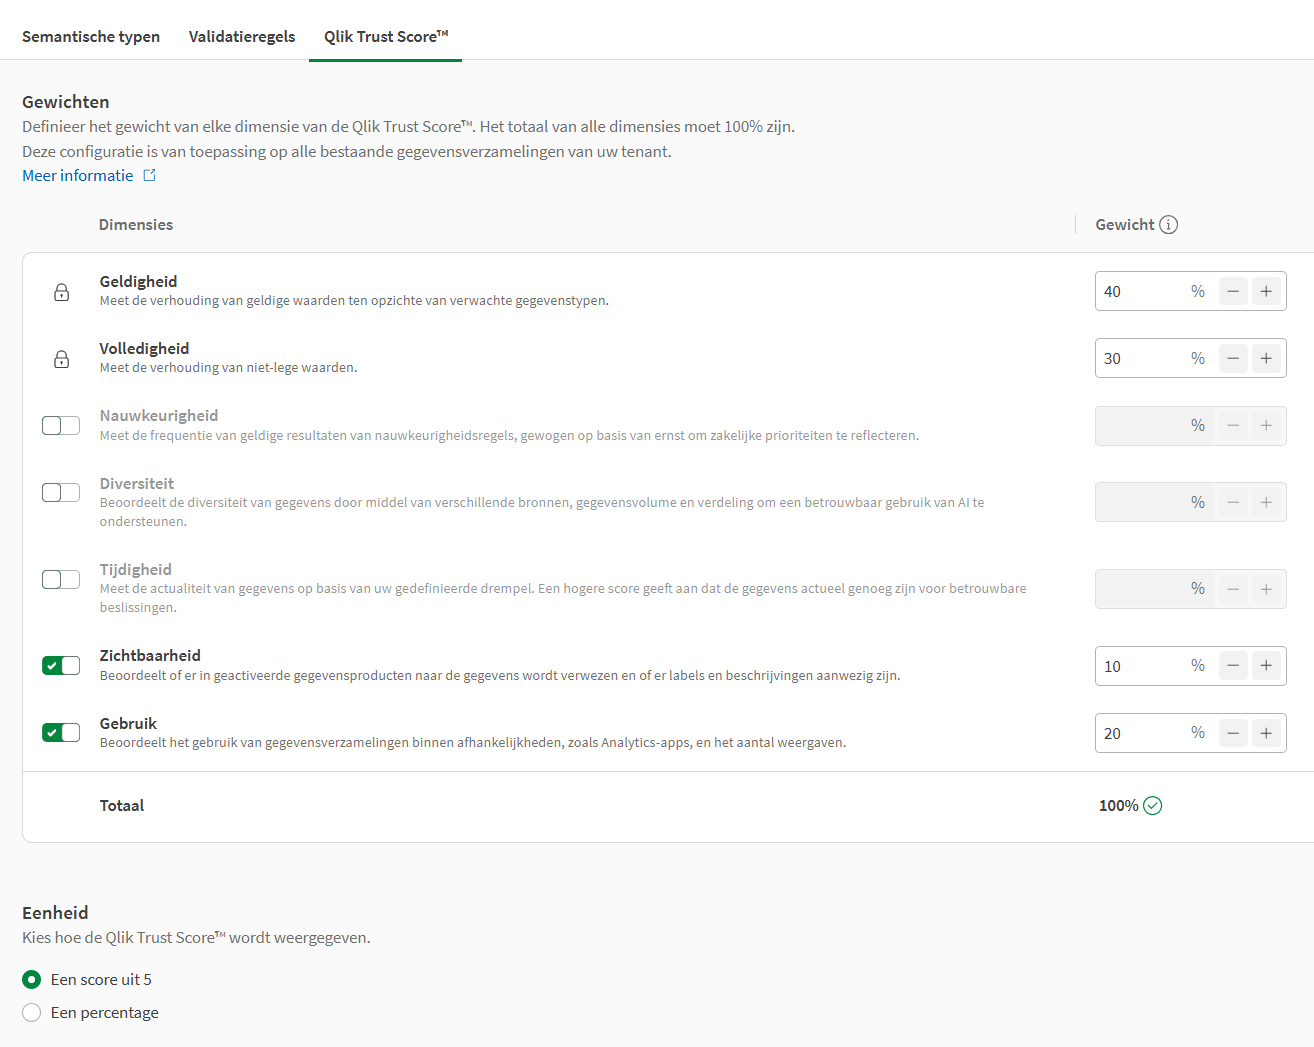
QTC bevat krachtige functies voor datakwaliteit en databeheer. Hierdoor kun je de kwaliteit van je data eenvoudig controleren en verbeteren. Elke dataset krijgt een Qlik Trust Score op basis van een 5-puntsschaal, waarin factoren als geldigheid, volledigheid, zichtbaarheid, gebruik, tijdigheid, nauwkeurigheid en diversiteit worden meegewogen.
Van ruwe data tot een AI-ready dataproduct
De QTC-reis begint eigenlijk met het einddoel: betrouwbare dataproducten. Dit laat namelijk zien wat je uiteindelijk met QTC voor elkaar kunt krijgen.
Data marketplace
Dit is het eindpunt en de centrale plek waar eindgebruikers de gevalideerde dataproducten kunnen vinden en consumeren. Een dataproduct is een entiteit waarmee je betrouwbare datasets kunt verzamelen en bundelen die betrekking hebben op hetzelfde domein, of op een andere groepering die zinvol is voor je organisatie. Zo kun je bijvoorbeeld 1 dataproduct creëren voor sales, waar je 5 datasets aan toevoegt (orders, klanten, verkopers, vervoerders en producten). Het dataproduct krijgt een score voor gegevenskwaliteit die natuurlijk voortkomt uit de scores voor de onderliggende datasets.


Dataproducten (goud)
Voordat een dataproduct in de marketplace verschijnt, wordt deze voorbereid door de dataproduct manager. De datasets worden verrijkt met metadata en worden geanalyseerd op kwaliteit met behulp van de Qlik Trust Score. Met metadata moet je denken aan het toevoegen van documentatie en beschrijvingen van datasets (die ook AI-gegenereerd kunnen worden). Het definiëren de datakwaliteit doe je aan de hand van semantische types, validatieregels en de weging van de Qlik Trust Score dimensies.
AI
Gestructureerde data die voor AI gebruikt kan worden, zal ook klaargezet worden in deze laag. Voor AI is het belangrijk dat de echt alleen de noodzakelijke data beschikbaar wordt gesteld. Dit om de performance van AI te verbeteren en niet te veel rekenkracht te gebruiken. Denk hierbij aan geaggregeerde tabellen met niet te veel rijen en alleen de noodzakelijke kolommen die van belang zijn in AI-vraagstukken.
Data transformatie en voorbereiding (zilver)
De datasets moeten natuurlijk ergens uit voortkomen, dit gebeurt via aan data pipeline in QTC. In de laatste fases van een QTC-pipeline wordt de data gecombineerd, opgeschoond en verrijkt. De datasets worden omgezet naar bruikbare structuren die klaar zijn voor consumptie door BI, AI of andere doeleinden. Het transformeren van data kan in een QTC-pipeline op twee manieren:
1. SQL-transformaties. Hiermee kun je SQL queries invoeren in je pipeline om complexe of simpele transformaties te definiëren. Je kunt ook de SQL-assistent een query laten genereren vanuit een tekstprompt met behulp van generatieve AI.
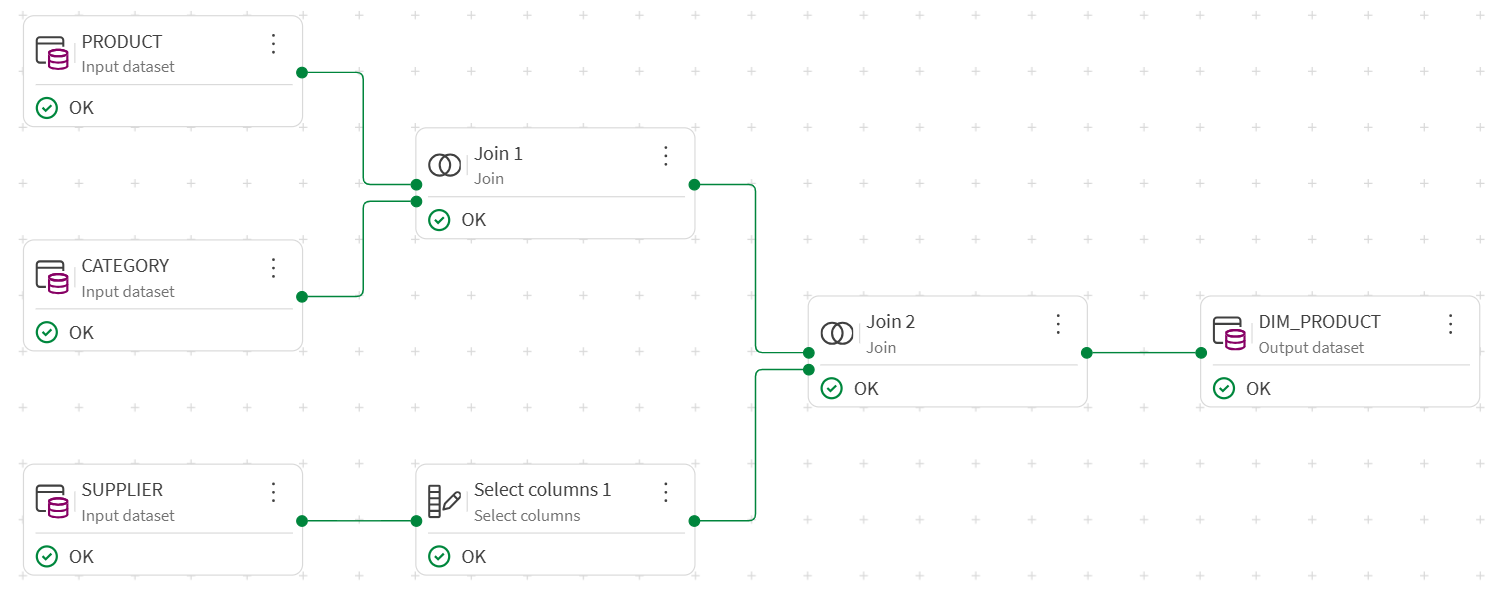
2. Visuele transformatiestroom. De drag-and-drop interface maakt het creëren van transformaties visuele transformatiestromen erg eenvoudig. Dit geldt voor zowel de ervaren data engineers als voor de niet SQL-experts. De ontwerper biedt een scala processoren om je data te transformeren zoals aggregeren, samenvoegen, opschonen, numerieke functies en filteren van data. Op de achtergrond converteert QTC de transformatiestromen naar SQL-statements en pusht deze naar je gewenste dataplatform.
Inname van ruwe data (brons)
De eerste stap bij het creëren van een data pipeline in een QTC-project betreft het vrijgeven van de data. Hierbij wordt de data overgebracht van de bron naar het gewenste dataplatform. Het vrijgeven van de data wordt in één bewerking gedaan, maar wordt in twee stappen uitgevoerd:
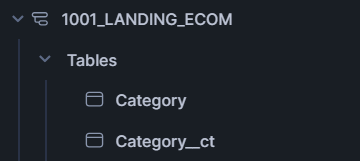
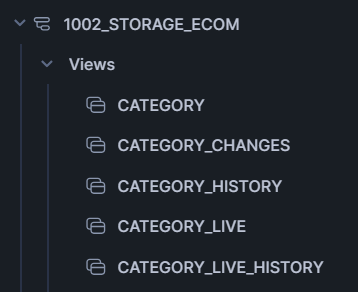
1. Landing. Hierbij wordt de data continu overgebracht van de bron naar een tussenopslag. Er worden twee tabellen gecreëerd: één voor de initiële lading en één voor de wijzigingen (__ct suffix). Hier ligt de kracht van QTC waar met change data capture (CDC) alleen de wijzigingen worden opgehaald, zonder enige vorm van codering.
2. Storage. Deze taak bevat het samenvoegen van de initiële lading en de wijzigingen. Daarnaast kun je er hiervoor kiezen om historische data op te slaan, zodat u eenvoudig gegevens opnieuw kunt maken op basis van een specifiek tijdstip in het verleden. Als laatste kan je in de storage taak kiezen om een live weergave te maken om de tabellen met de laagste latentie te lezen.

Governance
Wat betreft governance zijn er talloze mogelijkheden in QTC. Zoals de datakwaliteit & Qlik Trust Score die hierboven al behandeld zijn als eindproduct van QTC.
- Datakwaliteit & trust score. Dit waarborgt de kwaliteit en zorgt voor transparantie en vertrouwen bij de eindgebruikers.
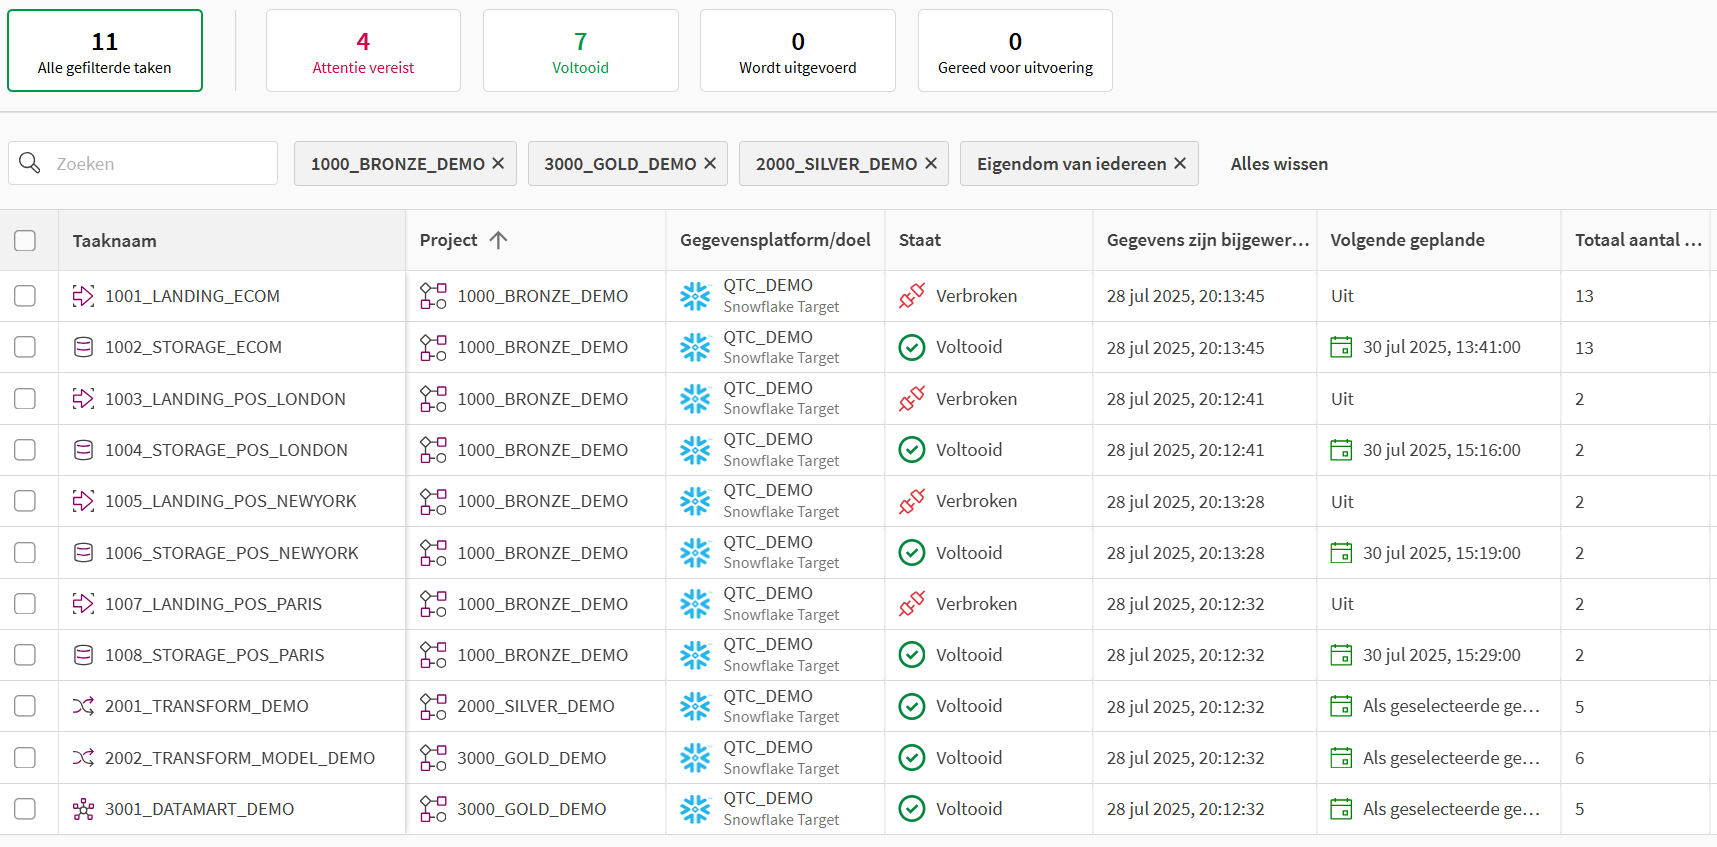
- Voortgangsweergaven. Hiermee kan je een aangepaste weergave creëren die bepaalde QTC-taken monitoren. Je kunt filters instellen op allerlei vlakken en je eigen kolommen kiezen voor de weergave. Hiermee kun je bepaalde QTC-taken groeperen en eenvoudig monitoren.
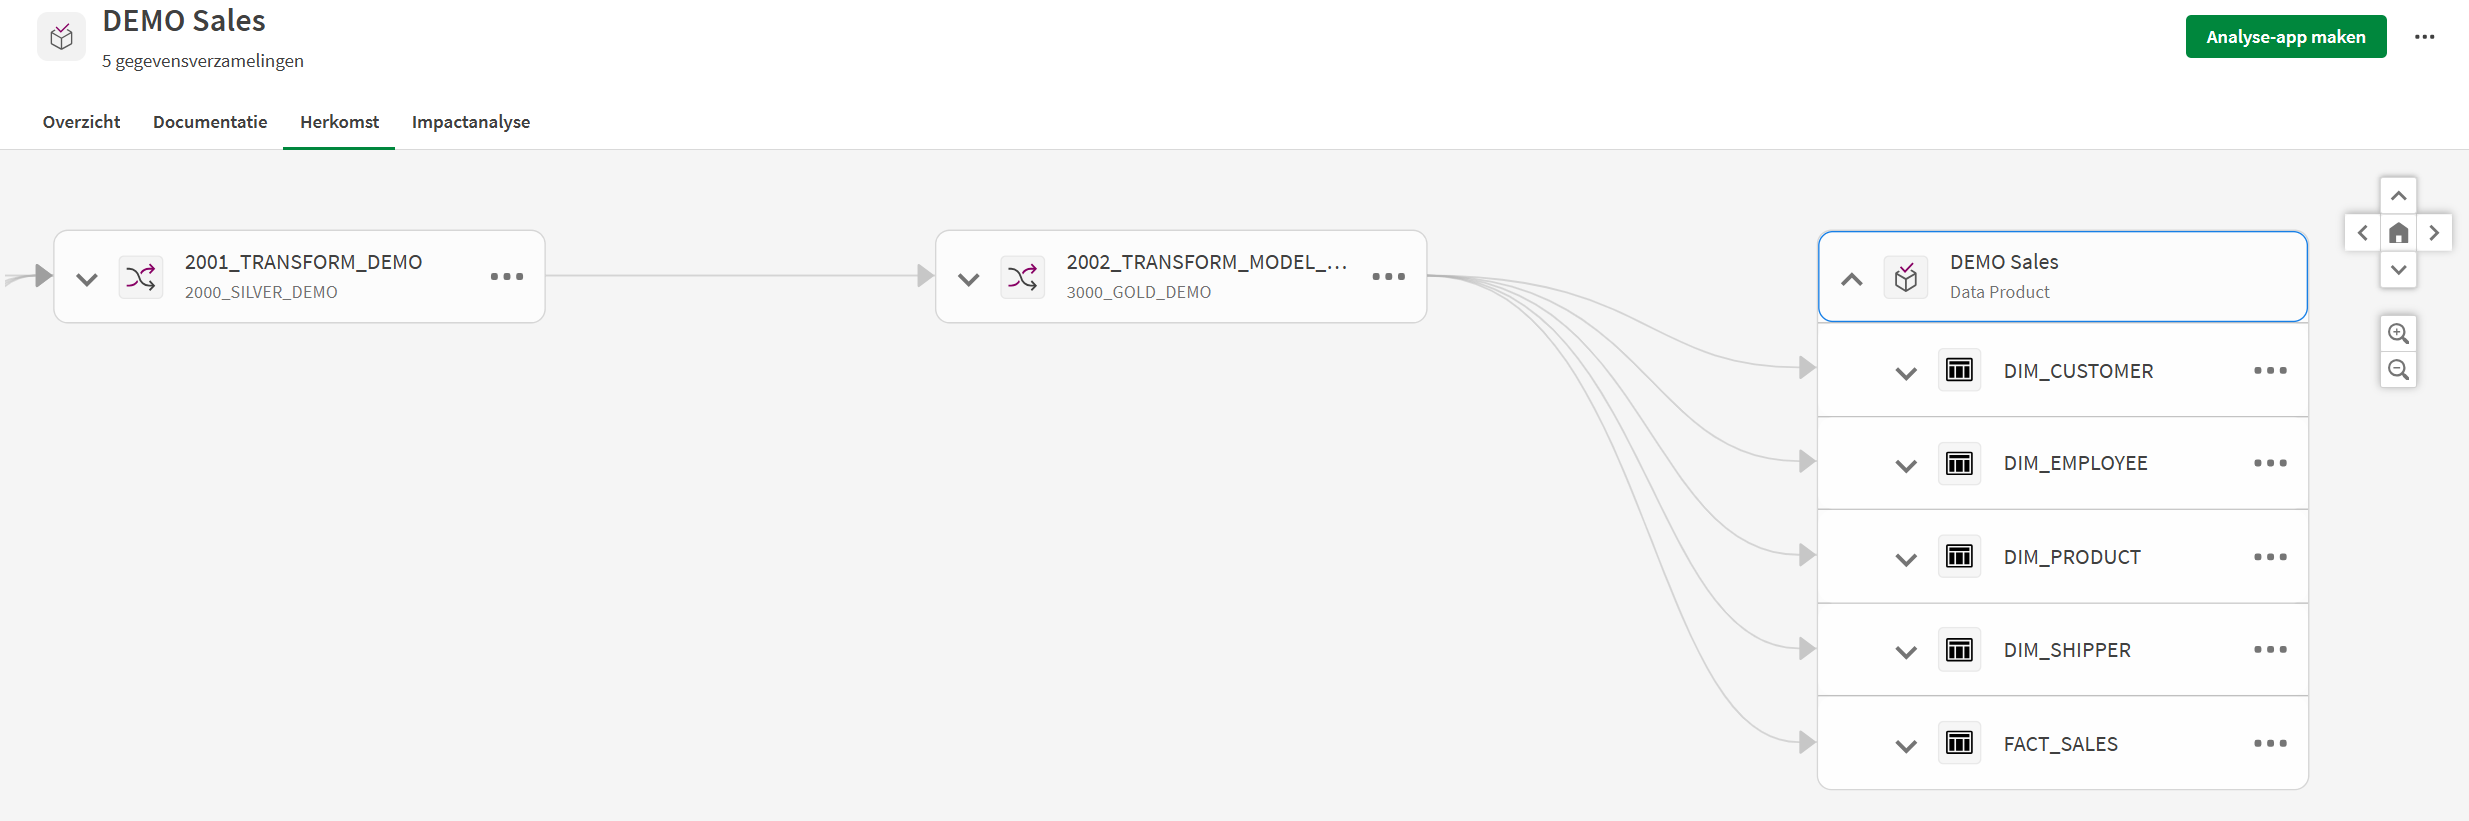
- Data lineage. In de Qlik cloud zijn er mogelijkheden om in een visuele weergave de herkomst van de data terug te herleiden naar de oorspronkelijke bron. Dit is volledig geautomatiseerd en wordt real-time bijgewerkt. De lineage visualisatie biedt een overzicht van de belangrijkste afhankelijkheden:
- Gegevenstaken in QTC die zijn gebruikt om een afgeleide taak te maken.
- Directe koppelingen en afhankelijkheden, inclusief eigenaar en ruimte.
- Originele bron
Toegangsbeheer & beveiliging. In de Qlik cloud is alle toegang gebaseerd op rollen. Hierin krijg je standaard gedefinieerde rollen vanuit Qlik, maar heb je ook de mogelijkheid om je eigen rollen te creëren. Verder is het ook mogelijk om de Qlik tenant te koppelen aan een eigen identity provider (bijv.: Microsoft Entra, Okta, Google of Salesforce) en daarmee de rollen en rechten te beheren met groepen.
Dataplatform
In QTC heb je verschillende dataplatform keuzes, afhankelijk van je use case. De belangrijkste opties zijn de volgende:
- Cloud data warehouse. Denk hierbij aan Snowflake, Google BigQuery, Amazon Redshift, Databricks, MS Fabric en Azure Synapse. Bij een keuze voor Redshift, Databricks of MS Fabric heb je een separate tussenopslag nodig in bijvoorbeeld Amazon S3.
- Traditionele database. Hieronder valt de traditionele on-premise database. De enige optie hierin is MS SQL server. Deze optie is het minst kost efficient.
- Qlik Cloud. Deze optie biedt alleen de bronzen laag als optie, waarbij de data vanuit de bron wordt vrijgegeven. Aansluitende transformaties zijn hierbij niet mogelijk. Voor de landing taak is een tussenopslag nodig in Amazon S3. Tijdens de storage taak wordt een QVD-bestand gegenereerd op je Qlik tenant.
Blueprint
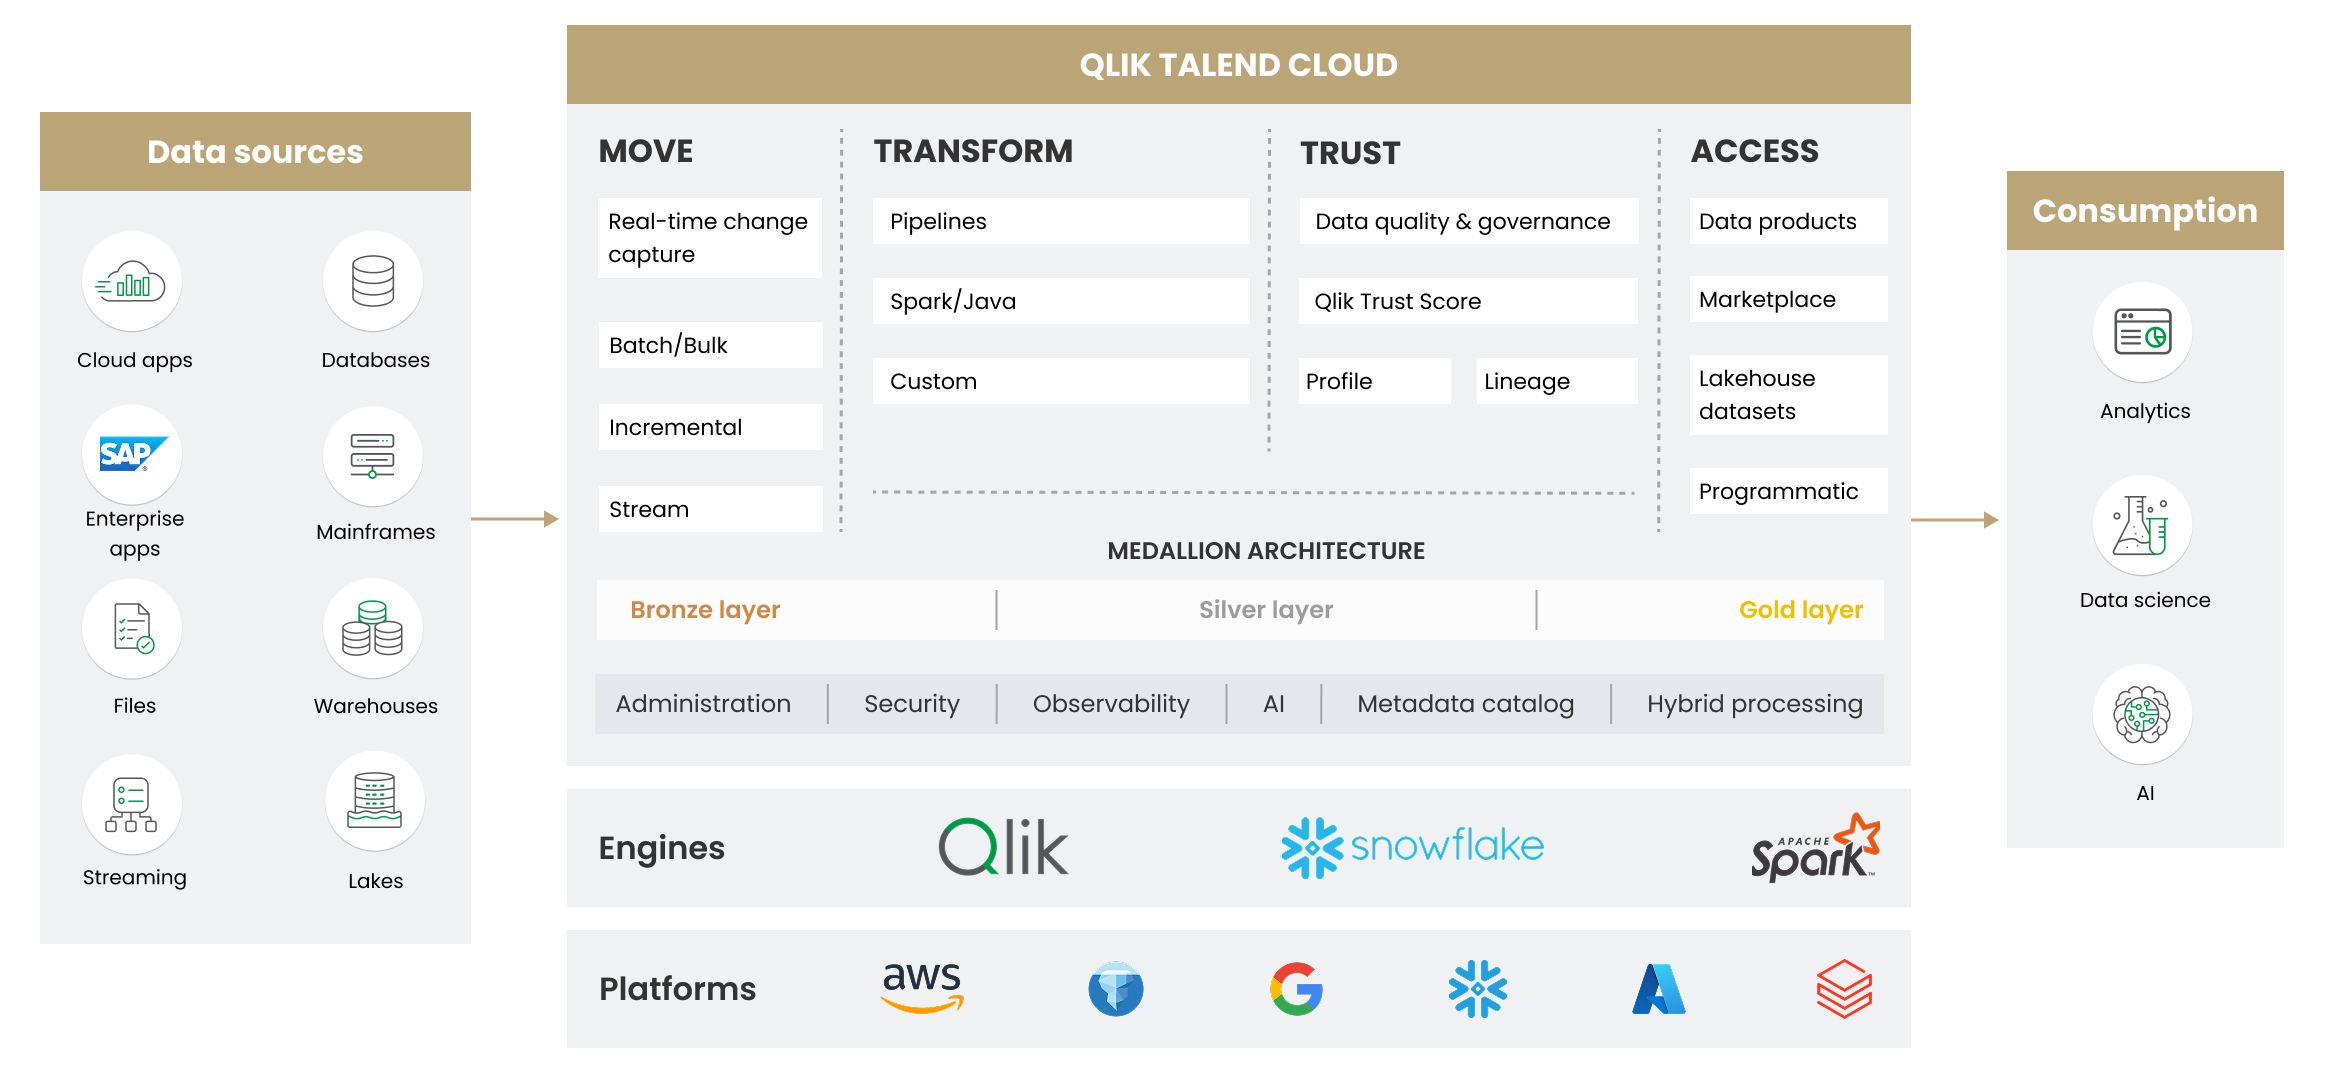
Bij Victa streven we altijd naar een medallion architectuur. Dit is een ontwerp patroon voor datamanagement waarbij de data wordt georganiseerd in een opeenvolgende lagen: brons, zilver en goud. Elke stap vertegenwoordigt een verbetering in de kwaliteit en structuur. Van ruwe data (brons), naar getransformeerde data (zilver), tot uiteindelijk de business-ready data (goud). Deze architectuur wordt ook goed benadrukt in de verschillende data taken binnen een QTC-project. Denk hierbij aan landing & storage voor brons, transformation voor zilver en datamart voor goud. Voor deze verschillende lagen werken we ook met gestandaardiseerde naamgevingen om meer duidelijkheid te verschaffen in de structuur.
Contact
Zelf aan de slag Qlik Talend Cloud?
Plan direct een kennismaking met een van onze BI-specialisten. We laten je zien hoe je deze tools optimaal combineert voor meer grip op je data – praktisch, concreet en afgestemd op jouw situatie.
Dit formulier wordt beschermd door reCAPTCHA, het
privacybeleid en de
servicevoorwaarden van Google zijn van toepassing.